Tencent DSpine: Qwen3.8-27B를 약 3배 빠르게 돌리는 추측 디코딩 드래프트 모델 공개
무엇인가요
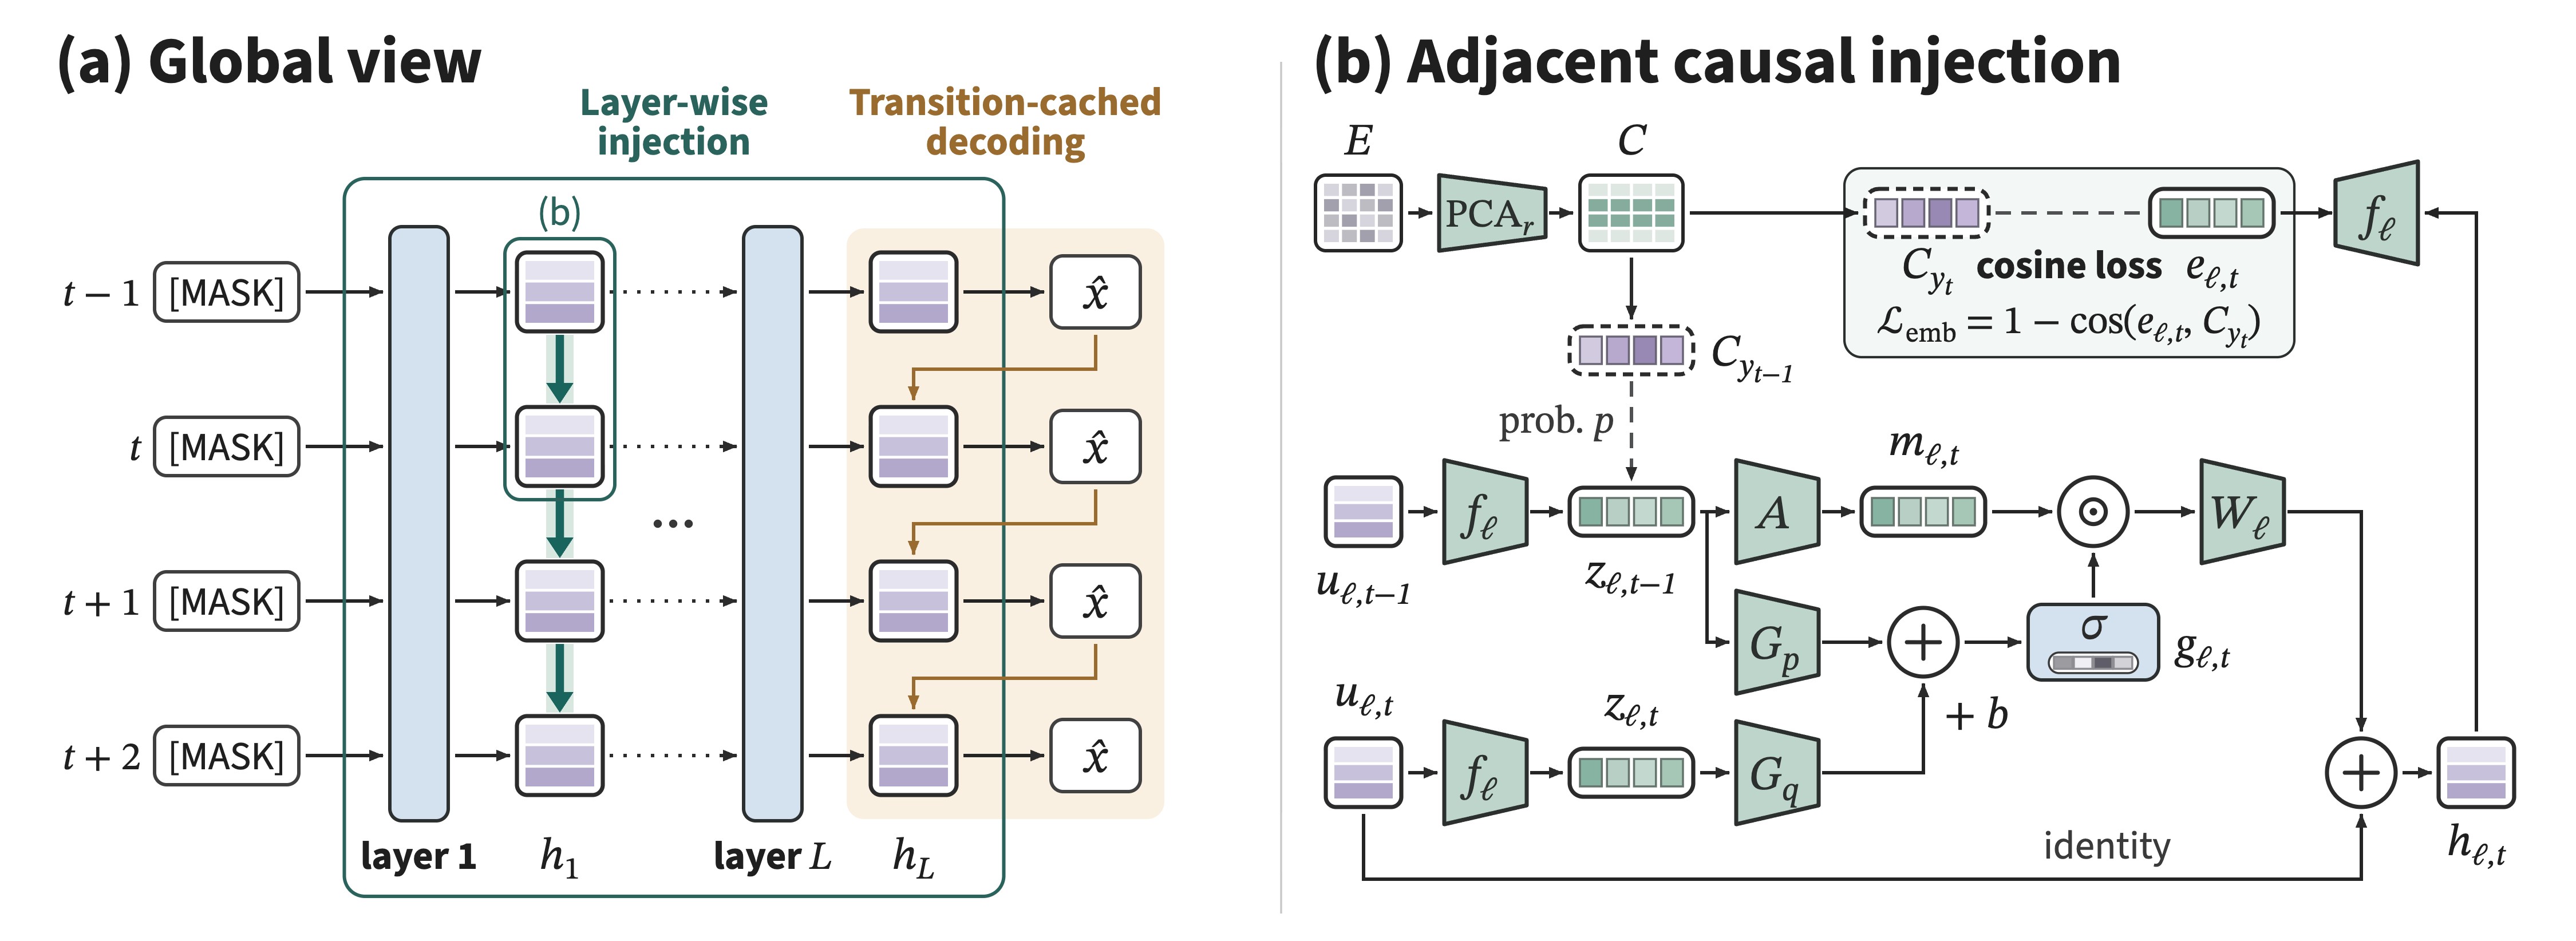
추측 디코딩(speculative decoding)은 작은 드래프트 모델이 다음 토큰 여러 개를 먼저 짐작하고 큰 모델은 그걸 한 번에 검사만 해서 생성 속도를 올리는 방법이에요. DSpine은 Tencent가 만든 드래프트 방식으로, 토큰 16개를 한꺼번에 짐작하면서도 층을 거치며 앞뒤 토큰의 관계를 반영해요. 이번에 Qwen3.8-27B용 5층짜리 드래프트 모델을 Apache 2.0으로 냈어요. 저장소의 SGLang 플러그인을 설치한 뒤 서버를 띄울 때 드래프트 모델만 지정하면 돼요.
git clone https://github.com/tencent/dspine.git && cd dspine && python -m pip install -e .
sglang serve --model-path /path/to/Qwen3.8-27B --speculative-algorithm DSPINE --speculative-draft-model-path tencent/Qwen3.8-27B-DSpine-b16 --speculative-num-draft-tokens 16 --trust-remote-codeQwen3.8-27B에 필요한 나머지 옵션(ReplaySSM, 동적 검증 튜닝)은 저장소 README에 정리돼 있어요.
왜 중요한가요
Qwen3.8-27B는 한 장의 GPU에 올려 코딩 에이전트로 쓰는 팀이 많은 모델이라, 같은 장비에서 응답이 빨라지면 바로 체감돼요. Tencent가 코딩·웹·오피스 에이전트 대화와 SWE-bench Pro를 다시 돌려 잰 처리량은 일반 디코딩보다 2.7~3.8배업체 주장였고 기존 공개 드래프트 DFlash2보다 한 번에 받아들여지는 토큰도 많았다고 해요업체 주장. 출력 품질은 그대로 두고 속도만 올리는 방식이라 서빙 비용을 줄이려는 팀이 먼저 시험해 볼 만해요.
완성도
GA 정식가중치와 추론 코드가 모두 공개돼 지금 내려받아 쓸 수 있어요. 다만 SGLang 0.5.22와 CUDA, Python 3.11 이상이 필요하고 수치는 모두 Tencent가 직접 잰 값이에요.
앞으로 이렇게 지켜보세요
- 독립 측정: 다른 GPU와 실제 서비스 트래픽에서 잰 속도가 SGLang 커뮤니티나 GitHub 이슈에 올라오는지 보세요.
- 지원 확대: vLLM 지원이나 다른 모델용 드래프트가 Hugging Face tencent/dspine 컬렉션에 추가되는지 확인하세요.
- Apple Silicon: MLX 경로가 Qwen3.8-27B까지 넓어지는지 GitHub 저장소 News를 지켜보세요.